
很多毕业生都有这样的经历:辛辛苦苦写了几个月的论文,上传到知网、万方后,却发现下载量寥寥无几。问题不一定出在论文质量上,而可能出在——关键词压根没选对。
在百度学术、Google Scholar、知网等平台上,关键词是检索系统判定论文主题的主要依据。关键词选得准,论文能呈现在精准读者面前;选得偏,论文就是“藏在深巷里的酒”,再香也无人问津。
不少学生的选词方式是“临时拍脑袋”:从题目里拆几个词,或者从摘要里抄几个词,凑够3-5个就提交了。这种做法忽略了平台检索规则和读者搜索习惯,导致论文曝光率大幅降低。
一篇论文的价值,不仅在于“写得好”,还在于“被看见”。而关键词,就是让论文被看见的“路标”。接下来的三个技巧,能帮你在不改变论文内容的前提下,有效提升检索率。
一、技巧一:用“主题拆解法”替代“标题摘词法”
核心痛点:直接从标题和摘要里提取的词,往往太宽泛或太窄,检索时匹配度低。
标题摘词法看似快捷,但存在一个逻辑漏洞——标题和摘要表达的是“你写了什么”,而检索系统优先匹配的是“读者在找什么”。两者重叠度并不高。
以“基于深度学习的电商用户评论情感分析”为例,直接摘词你会得到:深度学习、电商、用户评论、情感分析。这些词不是不能用,而是太“大路货”。检索“深度学习”的读者很可能是在找算法综述,检索“电商”的读者可能在找营销策略,真正对你的论文感兴趣的读者,输入的检索词往往更精细。
解决方案:采用主题拆解法,把论文的核心贡献拆成“研究对象 + 研究方法 + 应用场景 + 创新点”四个维度,每个维度筛选合适的词。
具体操作分三步:
画出论文的“主题树”:
– 研究对象(被分析的客体,如“用户评论”“消费行为”“政策文本”)
– 研究方法(如“情感分析”“LDA主题模型”“实证研究”)
– 应用场景(如“电商平台”“社交媒体”“公共治理”)
– 创新点(如“细粒度情感分类”“跨领域迁移”)
从每个分支中筛选核心词,再合并去重;
用学术数据库的“检索建议”功能测试选词效果——在搜索框输入候选词时,观察下拉提示和相关文献数量,数量过多说明词太宽泛,过少说明太冷门。
以“基于深度学习的电商用户评论情感分析”为例,按拆解法应调整为:
| 维度 | 候选关键词 | 检索匹配度(模拟) |
|---|---|---|
| 研究对象 | 用户评论、在线评论 | 匹配度高,常见检索词 |
| 研究方法 | 深度学习、情感分析、神经网络 | 中高等匹配度 |
| 应用场景 | 电商平台、电子商务 | 匹配度高,但需细化 |
| 创新点 | 评论情感分类、意见挖掘 | 匹配度中等,竞争较少 |
这样调整后,关键词既覆盖了读者常见的检索入口,又体现了论文的侧重点,检索曝光率明显提升。
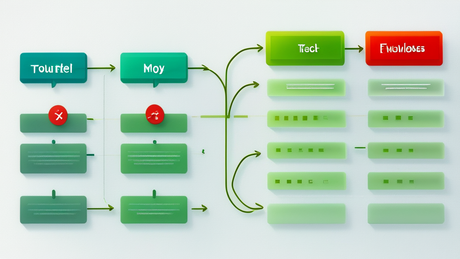
主题拆解法流程示意
二、技巧二:用“精准匹配”代替“泛词堆砌”
核心痛点:选词时贪多求全,结果每个词都没做到精准。
不少论文的关键词列表中,能同时看到“大数据”“人工智能”“对策”“研究”这类高频泛词。这些词本身没有错,但放在关键词位置,效果约等于零——因为搜这些词的读者,几乎不可能精准定位到你的论文。
来看一组常见的数据参考:在知网以“大数据”为关键词检索,返回结果数以十万计。在这样量级的竞争环境中,一篇普通论文被注意到的概率微乎其微。而用“大数据+用户画像+精准营销”组合检索,结果范围大幅缩小,且读者意图更加明确——他们就是在找这个方向的文献。
解决方案:控制单个关键词的信息量,确保每个词都有明确的“检索定位”。
具体操作原则如下:
• 原则一:每个词都能独立表达论文的一个侧面。 比如“情感分析”能独立表达方法维度,“用户评论”能独立表达研究对象维度。
• 原则二:避免“定语式堆砌”。 有些学生习惯把“基于深度学习的电商用户评论情感分析方法研究”整个短语作为关键词,这在知网检索中反而匹配度极低——因为完整短语几乎没有任何读者会直接输入检索。
• 原则三:保留合理的“别名”空间。 有些概念有不同叫法,比如“在线评论”和“网络评论”,“意见挖掘”和“观点提取”。根据论文实际内容,在关键词中选用更主流的叫法,或者同时保留两个变体,能覆盖更多检索入口。
一个常用的检查标准:把关键词输入学术数据库,看排在前面的文献与你论文的相关度。如果前20篇里几乎没有主题相近的论文,说明关键词的匹配方向可能有偏差,建议调整。
| 场景 | 错误示范 | 正确示范 |
|---|---|---|
| 检索匹配度 | 大数据(太泛) | 用户行为数据分析(定位明确) |
| 检索匹配度 | 人工智能(泛词) | 机器学习分类模型(方法明确) |
| 检索匹配度 | 对策研究(无信息量) | 消费者信任修复策略(对象+方法结合) |
泛词与精准词检索对比
三、技巧三:利用工具反向“抄”关键词
核心痛点:自己凭感觉选词,容易漏掉学术共同体的“规范用语”。
每个学科都有约定俗成的术语体系。同一个概念,学术论文中可能用“在线评论”,而日常口语中叫“网上留言”。检索时,学术数据库优先匹配前者。如果关键词用的是后者,系统识别度就会大打折扣。
解决方案:不要凭空造词,而是借助工具反向获取“学术规范关键词”。
有两条高效的路径:
路径一:从已发表文献中反查关键词。 找到同领域近几年的高水平文献,翻看它们的关键词列表,统计高频词。举例来说,如果你研究的是“在线评论有用性”,参考同方向文献后会发现,核心词高频集中在“信息采纳”“感知有用性”“评论质量”“文本特征”这几个术语上。这些就是该领域的学术规范用语。
路径二:利用AI工具生成候选词并交叉验证。 以AI工具(如ChatGPT、文心一言)辅助提取关键词时,采用如下对话策略:
把论文摘要粘贴给AI,提出明确要求:“请从以下摘要中提取8-10个候选关键词,要求包含学术术语、研究方向、方法论维度,并按与主题的相关性排序。”
AI生成后,再做一步交叉验证——把候选词逐一放进中文期刊数据库检索,观察返回文献的相关程度。这一步能帮你过滤掉AI生成的“看似合理但检索匹配度低”的词。
另外,知网“关键词推荐”功能值得一试。在知网搜索框输入论文题目后,页面会自动展示相关文献的关键词分布,高频出现的词,就是本领域的主流术语。把这些词作为关键词选项,就能和学术共同体保持术语一致,检索匹配度显著提升。
知网关键词推荐界面
四、效果验证:用“检索模拟”检验选词质量
关键词选完后,别急着提交,用三分钟做一个快速验证,评估检索效果。
验证方法是“模拟读者检索场景”:
假定自己是目标读者,想找你所写领域的文献;
在学术数据库输入每个关键词,快速浏览返回的前三页结果;
询问自己:返回结果中,与你论文主题相关的文献占比高不高?
这个测试有两个可能的结果:
| 测试结果 | 含义 | 调整策略 |
|---|---|---|
| 返回结果相关度高 | 关键词准确反映了主题 | 保持现有选词,适当调整顺序(核心词排前) |
| 返回结果相关度低 | 关键词过于宽泛或偏离 | 重新拆解主题维度,合并同类词,淘汰泛词 |
这个验证过程不需要额外工具,在知网、万方或百度学术上操作即可,全过程三分钟内能完成。
另一个实操建议:关键词排序同样影响检索效果。 学术数据库检索时,关键词顺序通常按相关度降序排列。第一个关键词对应论文最核心的贡献维度,第二、第三个词对应支撑维度。有些学生习惯把“研究”或“分析”这类无信息量的词放在前排,浪费了展示相关度的机会。
按“核心方法 > 核心对象 > 应用场景 > 扩展维度”的排序逻辑来组织关键词,检索系统能更准确地判断你的论文主题归属。
关键词调整前后检索效果对比
五、总结:关键词选得好,论文“流量”翻倍
关键词是论文的“门牌号”,门牌号错误,再好的内容也无缘被读者发现。回顾三个核心技巧:
主题拆解法:从研究对象、研究方法、应用场景、创新点四个维度拆解论文,替代“标题摘词”的随意性;
精准匹配:用信息量充足的术语词替代泛词,控制每个关键词的识别精度;
工具反向验证:从文献关键词统计和AI辅助中获取学术规范用语,再用数据库检索测试来把关筛选。
最后一步行动建议:花15分钟完成选词与验证全流程。先拆解主题维度,再逐词验证,最后按“核心方法、核心对象、应用场景、扩展维度”的顺序排序。这样操作下来,论文的检索曝光率明显提升只是时间问题。
你的论文质量已经过关,别再让关键词拖了后腿。趁提交前,花一杯咖啡的时间,把关键词重新打磨一遍——这可能是论文“被发现”的最短捷径。



暂无评论内容